SERVICE
事業内容
Tokyo city image

Our Applications: MiraiE Foundry

アプリケーション

MiraiE Foundry
MiraiE Foundry(ミラーエファウンドリー)

MiraiE Foundry(ミラーエファウンドリー)は、生成AI(LLM)を活用した統合型AIデータ基盤です。 紙文書・PDF・画像・手書きメモなど、これまでシステム化が困難だった「非構造化データ」を、AIが文脈を理解しながら読み取り、データベースや業務システムで活用可能な「構造化データ」へと変換します。 従来のOCRでは難しかった複雑なレイアウトの文書や、表記ゆれのある手書き文字にも対応。人手による転記作業を大幅に削減し、業務のデジタル化を加速させます。

Product image
Issue
現状課題:深刻な人手不足と技能の継承
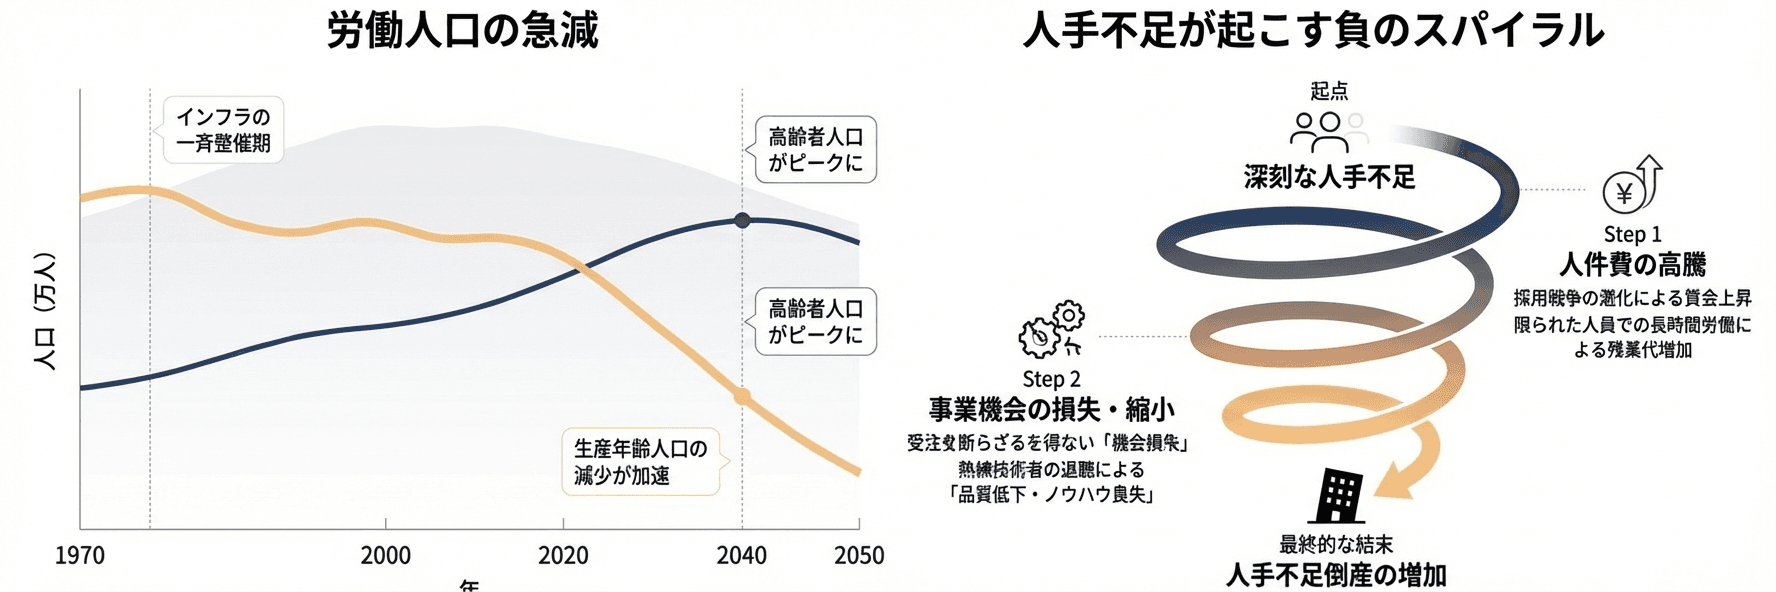
日本全体で労働人口の減少が進む中、行政機関や企業の現場では深刻な人手不足が発生しています。同時に、熟練した担当者の退職により、業務ノウハウの継承も困難になりつつあります。その結果、経験の浅い担当者が増加し、事務手続きの遅延や入力ミスが頻発。これらのミスは、行政サービスの質の低下や企業の信頼性毀損に直結するリスクとなっています。特に、紙文書やPDFからデータを手作業で転記する業務は、膨大な時間と労力を要するだけでなく、ヒューマンエラーの温床となっています。現場の負担軽減と業務品質の維持を両立させる仕組みが、今まさに求められています。
Issue image
Solution
解決策:MiraiE Foundryによるデータ基盤生成
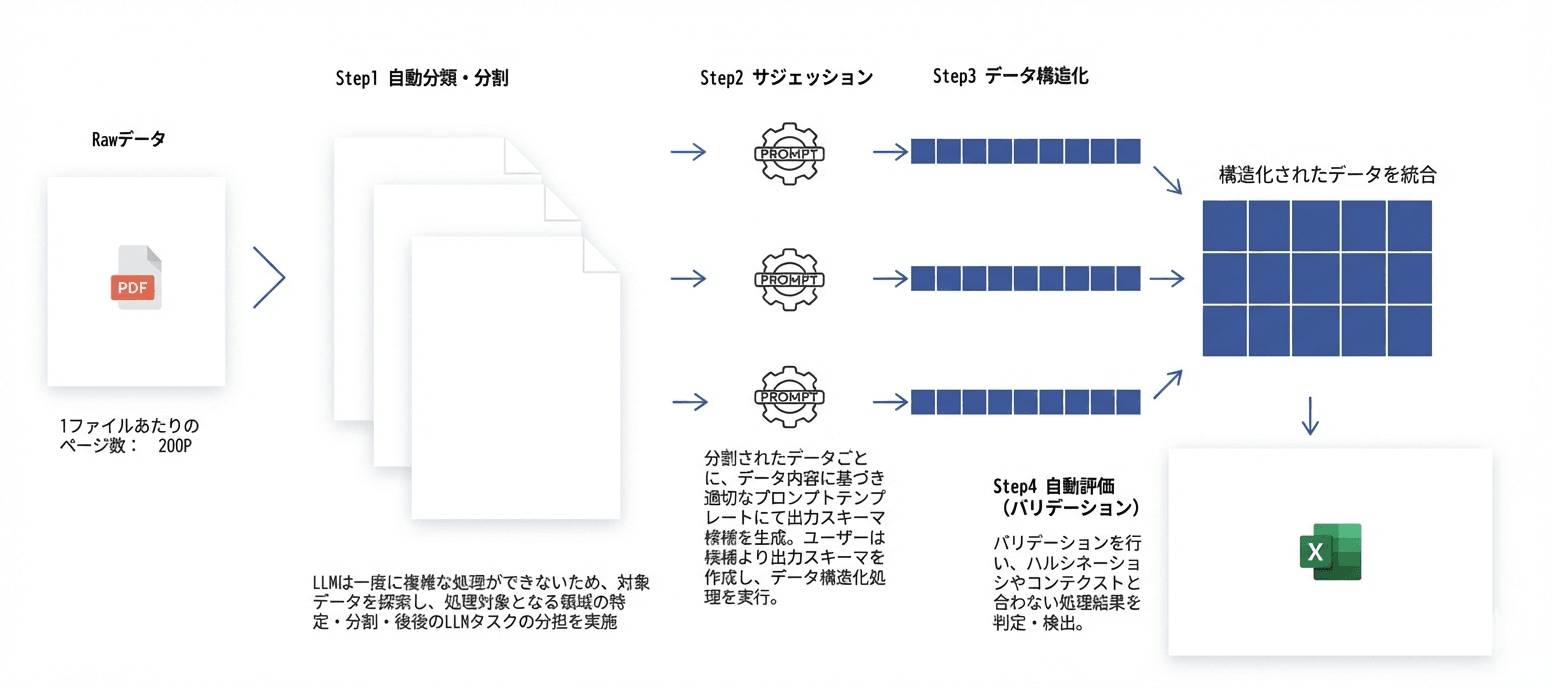
MiraiE Foundryは、生成AI(LLM)の「意味理解」と「論理補正」機能により、文書・画像などの非構造化データを高精度に構造化します。単なる文字認識(OCR)にとどまらず、文書全体の文脈を把握した上でデータを抽出。項目間の関係性や記載内容の整合性をAIが自動的にチェックし、矛盾や欠損があれば補正を行います。構造化されたデータは、既存の業務システムやデータベースとシームレスに連携可能。大規模なシステム改修を行うことなく、段階的なデジタル化を実現できます。
Solution image
Works
実績

MiraiE Foundryは、中央省庁や自治体のDXプロジェクトにおいて、その技術力と実用性が評価されています。

東京都 Kingsalmon Project 東京都が推進するスタートアップ支援事業「Kingsalmon Project」の先行実証に参画。住宅政策本部における審査業務を対象に、申請書類の自動判読・データ化の実証を行いました。

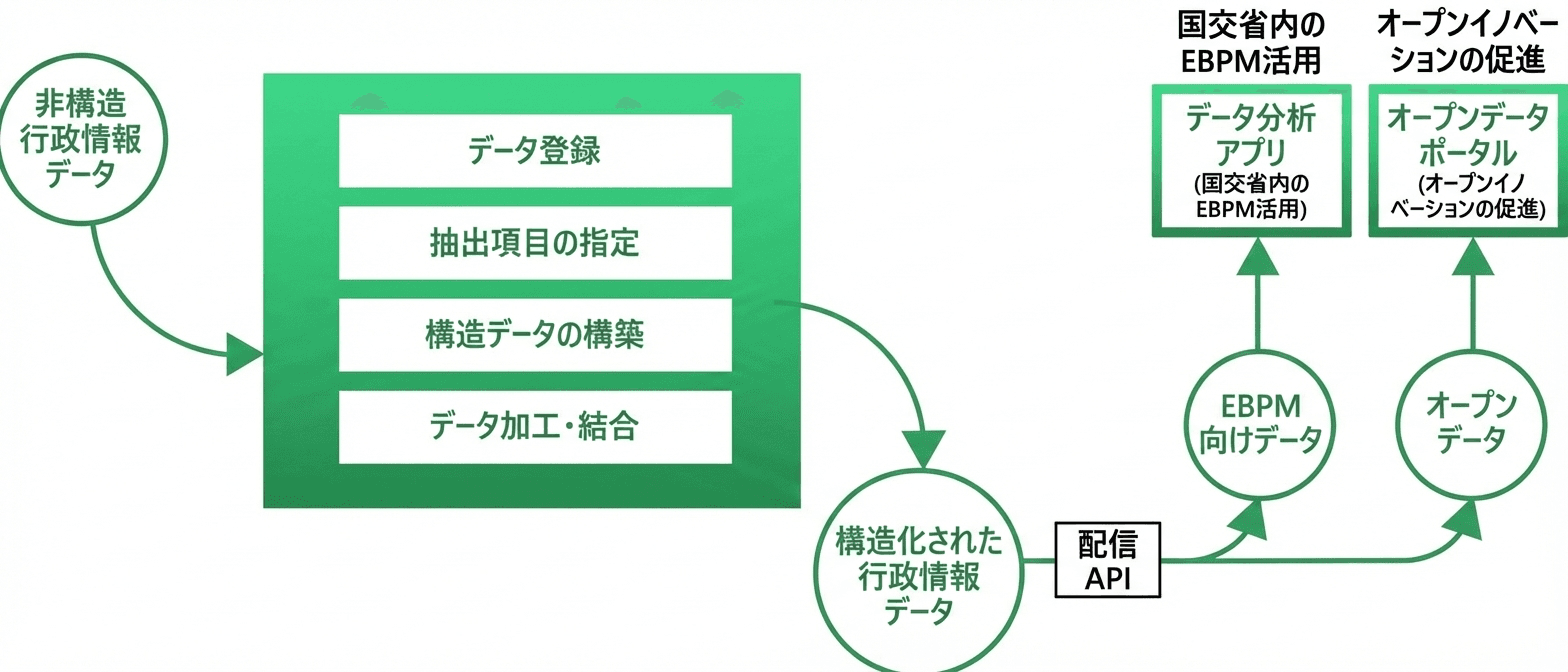
国土交通省 Project LINKS / LINKS Veda 国土交通省が推進する「Project LINKS」において、データ構造化アプリケーション「LINKS Veda(ヴェーダ)」の一部機能としてMiraiE Foundryの技術が採用されています。行政情報の構造化・オープンデータ化を通じて、EBPM(証拠に基づく政策立案)の推進とオープンイノベーションの促進に貢献しています。

MiraiE Foundry のデータ構造化APIを簡易アプリに埋め込み、行政文書からデータベースに取り込み可能な形式へと変換を行う事例です。

Works image
News
ニュース
MiraiE Foundryに関する最新のニュースをお届けします
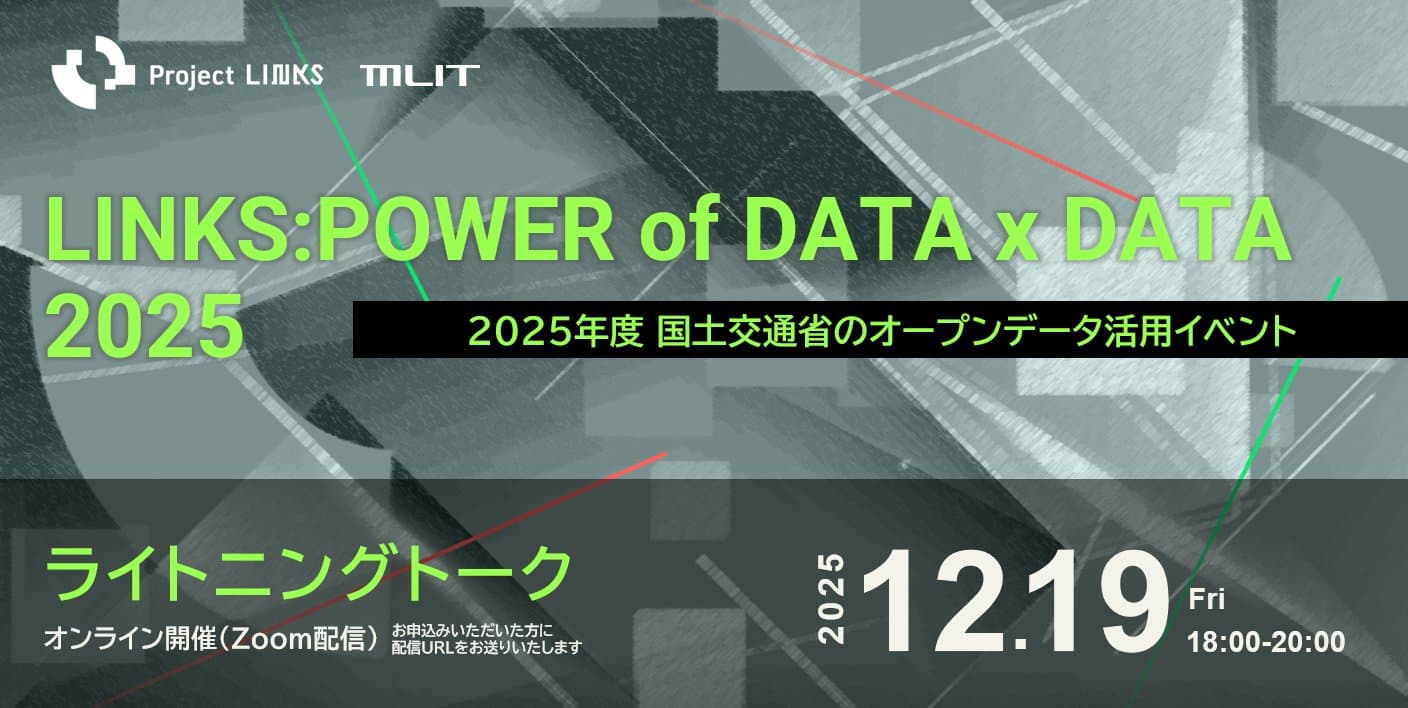
LINKS:POWER of DATA x DATA 2025 ライトニングトークのお知らせ

2025年12月5日

LINKS:POWER of DATA x DATA 2025 ライトニングトークのお知らせ

国土交通省が主導する、国土交通分野のデータ整備・活用・オープンデータ化プロジェクト「LINKS(リンクス)」が、 12/19(金)18時から、LINKS:POWER of DATA x DATA 2025 ライトニングトークを開催します。 当社の社員もコメンテーターとして出席致します。 LINKSのデータを使用したアプリやサービスのアイデアを参加者チームが持ち込んでピッチ形式で発表します。 イベント概要 項目内容イベント名【ライトニングトーク】LINKS:POWER of DATA x DATA 2025日時2025年12月19日(金) 18:00〜20:00形式ライトニングピッチ形式テーマLINKSデータを使った作品や体験、アイデアなど、LINKSに関する自由なテーマでお話をいただくオンラインイベント イベント詳細はこちらからご覧ください。

News
Default image

2025年10月7日

21世紀の産業革命を支える基盤としての「データ構造化」

はじめに — 21世紀の産業革命は「データ」から始まる 19世紀、鉄道は長距離移動や大量輸送を可能とし、生産体制や商流を劇的に拡大させ、産業革命のスピードとスケールを決定づけました。 21世紀の産業革命において、鉄道に相当する役割を担うのはどのような技術でしょうか? わたしたちはその一つがAIであると考えています。そしてAIが最大限に力を発揮するための“レール”こそが、データ、とりわけ構造化されたデータです。単に量を蓄えるだけでは不十分で、意味づけと文脈が揃ったデータモデルこそが、AIを事業価値へと接続します。 私たちは、非構造化データを事業のKPIや業務プロセスに接続する「使える構造」に変換することで、AIの潜在能力を現場の成果へ転換していきます。この「データ構造化」は私達が考えるDXの根幹技術です。詳しくは下記の記事をご覧ください。https://www.wantedly.com/companies/company_2609139/post_articles/1013461 なぜ「データ構造化」が不可欠なのか AIは入力に対して驚異的な推論・生成能力を示しますが、入力が曖昧で不統一なら、結果は再現されません。ここでいう構造化とは、次の3点を満たす状態を指します。 ・同じ意味のデータが同じ形式で表現される(標準化と正規化) ・時間・空間・主体(誰がいつどこで)という文脈を付与し、追跡可能である(トレーサビリティ) ・分析や自動化の単位に分解され、再利用できる(コンポーザビリティ) この状態になってはじめて、モデルの更新や追加学習、依存関係の変更を行っても、結果の整合性が保たれます。逆に、データが“文書”のまま漂っている限り、個別のPoCは成功しても、全社的な拡張でつまずきます。 捕捉:AI活用のボトルネックはアルゴリズムよりデータ設計。レールがなければ列車は走れない。 現場で起きている“真のボトルネック” ・DXが最も求められる現場ほど、紙や画像、PDF、音声などの“非構造化データ”が堆積する ・部門ごとに指標や用語がバラバラで、横断分析ができない(同じ語でも定義が異なる) ・効果検証が属人的になり、改善が再現されない(ファクトよりナラティブが先行) この壁を超えるには、OCRや音声認識といった“取り込み”の先に、タグ設計、スキーマ設計、参照設計(IDや地理・時間軸)までを含む体系的な「データ構造化」プロセスを敷くことが不可欠です。 業務や社会課題の解き方がどう変わるか(具体例) アプリやAIは一般的にマシンリーダブルなデータが必要です。アプリやAIが導入されることで、業務省力化や多部署連携が可能になり、人手不足による負担の解消や、付加価値向上に向けた取り組みが可能になると考えています。具体的には以下のような内容が考えられます。 業務効率化 ●検索と引き継ぎの時間短縮 ・文書・画像・音声をタグ分割し、用語辞書で正規化して「横断検索」を高速化 ・顧客や案件の時系列イベント(問い合わせ→見積→受注→請求)を1タイムラインに統合 ●現場入力の負担軽減 ・音声入力→項目自動展開(日時・場所・数量などを自動抽出) ・画像・PDFから数量やチェック項目を自動起票し、現場は確認のみ ●属人化の解消と教育コスト削減 ・業務手順をイベント単位に構造化し、ケースに応じた手順書をAIが提示 ・よくある判断の根拠をテンプレ化し、新任者の立ち上がりを短縮 ●優先順位付けとアラートの自動化 ・リスク徴候やSLA逸脱をルール化し、担当者や期日を自動割当 ・重要度×緊急度に応じたダッシュボードで「今やるべきこと」を提示 ●顧客対応の一次受け自動化 ・構造化FAQと過去対応ログを基に、チャットやメールの一次回答をAIが生成 ・重要案件は人にエスカレーション。応対履歴は自動でCRMに反映 ●需要予測と在庫・要員配置の最適化 ・受注・季節性・外部要因を学習し、在庫・シフト・工数を先回り調整 ●異常検知と品質管理の省力化 ・日報や検査記録を構造化し、閾値超過やパターン異常を自動検知 ・再発防止策を類似事例から自動提案 ●採用・人事の生産性向上 ・履歴書・職務経歴を構造化し、要件との適合度スコアを自動算出 ・面談ログを要約し、評価のばらつきを可視化 ●内部ナレッジの再利用 ・提案書・設計書・トラブルシュートを要素化し、ケース別に再組立 ・生成AIが「根拠付き」で回答と参照原本リンクを提示 ●コンプラと監査対応の効率化 ・契約・稟議・ログを時空間IDで紐づけ、エビデンス収集を自動化 ・ポリシー逸脱の自動検知と是正フロー起動 ●バックオフィス ・請求書・経費の自動読取と仕訳候補提示 ・稟議・契約期限の自動リマインドと更新下書き ●営業・CS ・商談メモからCRM自動更新と次アクション提案 ・問い合わせ一次対応ボット+ナレッジ参照 ●企画・レポート ・PDFや表の自動表構造化→定型レポート自動生成 ●製造・保守・建設 ・点検記録の音声→項目化と異常アラート ・施工写真から出来形チェックの自動化支援 ●自治体・公共 ・申請書のスキャンから項目抽出と横断突合 ・補助金や窓口問合せの集計と効果測定の自動化 社会課題の解き方 1.補助金政策の効果測定の高度化 ・交付情報、事業実績、受益者属性、地域指標を統一スキーマで連結 ・地域差や施策間の相互作用を見える化し、翌年度の配分ルールをデータドリブンに更新 ・結果の再現可能性が担保され、説明責任が強化される 2.インフラ老朽化の予測・予防 ・陥没・補修履歴、地質、交通量、地下埋設物、施工年を時空間IDで統合 ・「壊れてから直す」から「壊れる前に最適更新」へ。更新投資の優先順位が明確化 3.高齢者見守りと空き家対策の連携 ・福祉、固定資産、上下水、郵便、地域ボランティア情報を匿名化・連結 ・リスク徴候の早期検知と、支援・空き家対策の同時最適化が可能に 私たちのアプローチ:AIのための“レール敷設” 現場で回ることを最重視し、以下のステップで“非構造→構造→活用”を実装します。 1.データ取得 ・画像・PDF・手書き・音声を対象に、レイアウト認識とセマンティック分割を同時に実施 ・認識結果に信頼度と根拠(元ページ座標や音声タイムスタンプ)を付与 2.データ設計(タグ設計とスキーマ提案) ・用語辞書と同義語マップを作成し、現場の語彙を保ちながら標準化 ・業務イベント単位のデータモデルを提案し、レビューで確定 3.情報抽出(値抽出と参照設計) ・エンティティ間の関係(事案ID、地理メッシュ、時間粒度)を設計 ・欠損・矛盾の検出ルールを定義し、品質をモニタリング 4.データ活用(分析・運用・提示) ・ダッシュボード構築などの現場にあったUI/UXを構築し、現場の意思決定に直結した伴走を行います。 この一連の流れは、MiraiE.aiの現場導入を通じて磨かれてきたもので、現在は国土交通省のProject LINKSでも中核技術として展開しています。 まとめ — レールを敷いた先に、持続的な成果が生まれる AIを“走らせる”ためのレールは、自然には敷かれません。構造化されたデータがあることで、高速反復と再現性のある改善が回り、投資が複利で効く。広告やゲームなどデータリッチ産業の成長軌道は、その好例です。 私たちは、AI導入をレールから構築し、現場と並走して実装していきます。 「データ構造化」については、「LLMを用いて非構造データをデータ構造化してみた」の記事をぜひご覧ください。https://zenn.dev/microbase/articles/2f9f179fba7842

Column
Default image

2025年8月29日

生成AIモデルを比較検証してみた 〜VLMの精度を測る〜①丸囲み編

最近は生成AIやマルチモーダルモデル(VLM: Vision-Language Model)が話題ですが、「どのモデルがどのタスクに強いのか?」は意外と分かりづらいですよね。 そこで私たちは、オープンデータではじめるデータ構造化 〜生成AIでオープンデータを整理する〜でもあげた非構造データを対象に、文章抜き出しや丸囲み認識といった具体的な課題を設定し、複数の最新モデルを比較検証してみました。今回は、その一次結果を少しご紹介します。 どんなタスクを試したのか 今回の検証では、大きく2つのタスクに注目しました。 1.文章抜き出し スキャンされた文書から正しくテキストを抜き出せるか 実際の業務で最も多いユースケース 2.丸囲み認識 手書きや印刷物にある「○で囲まれた記号」を認識できるか 入力フォームや選択式の書類でよく出てくるケース 試したモデルたち 丸囲みが大量にあるデータを対象に検証したのは海外の有名VLM、クラウドベンダーが提供するOCR + LLMの組み合わせ、新興系の大規模モデルなど。いわば「世界のトップランナー」を一気に集めて比べてみた、というイメージです。 なお、今回は正答率を指標に、モデルの出力結果を定量的に評価しました。 一次結果のハイライト 1. OCR × LLM の組み合わせが強い 文章抜き出しタスクにおいては、高性能なOCRとLLMを組み合わせた構成が最も精度が高いという結果に。 OCR単体でもかなり強力なのですが、そこにLLMの補完が入ることでさらに精度が上がる傾向が見えました。 2. VLMはまだ苦戦する領域も 一方で、画像を直接理解するVLMは期待ほどのスコアが出ず、特に丸囲み認識では全体的に精度が低め。 「丸囲み」は人間にとっては簡単ですが、モデルにとってはまだ難しいタスクであることが浮き彫りになりました。 3. モデルごとの性格がはっきり テキスト処理に強いモデル コスト・速度のバランスが良いモデル 特定領域で尖った性能を出すモデル など、実際に比べてみると「どのモデルが万能」というよりは、ユースケースによってベストな選択肢が異なることが分かりました。 考察と次のステップ 今回の評価はあくまで一次結果です。 今後は以下のような追加検証を予定しています。 – 文字列類似度を考慮したスコア再算出 多少の表記揺れや誤差を吸収して、より実運用に近い評価へ。 – 前処理(クレンジング)後の再評価 入力データの品質を整えることで、モデルのポテンシャルを引き出せるか検証。 – 処理速度・コストも含めた総合評価 精度だけでなく、ユーザーが日常的に使える水準かどうかを重視。 まとめ OCRとLLMの組み合わせは文章処理に非常に強い VLMは進化中だが、図形系の認識には課題が残る モデル選定は「用途次第」であり、1つに決め打ちするのではなく柔軟な組み合わせが重要 AIの進化は日進月歩ですが、「実際に試し、数値で比べる」ことでしか見えないリアルな差があります。私たちは今後も継続して検証を行い、現場で使えるAIの形を探り続けていきます。 最後にちょっとだけPR ここまで読んで「面白そう」と思ってくださった方へ。 私たちは生成AIの最前線で、まだ答えのない課題に挑戦しています。エンジニア・データサイエンティスト・PdMなど、仲間と一緒に未来を形づくる人を歓迎しています。 興味があれば、ぜひ気軽に採用ページを覗いてみてください。

Column
Default image

2025年8月25日

オープンデータではじめるデータ構造化 〜生成AIでオープンデータを整理する〜

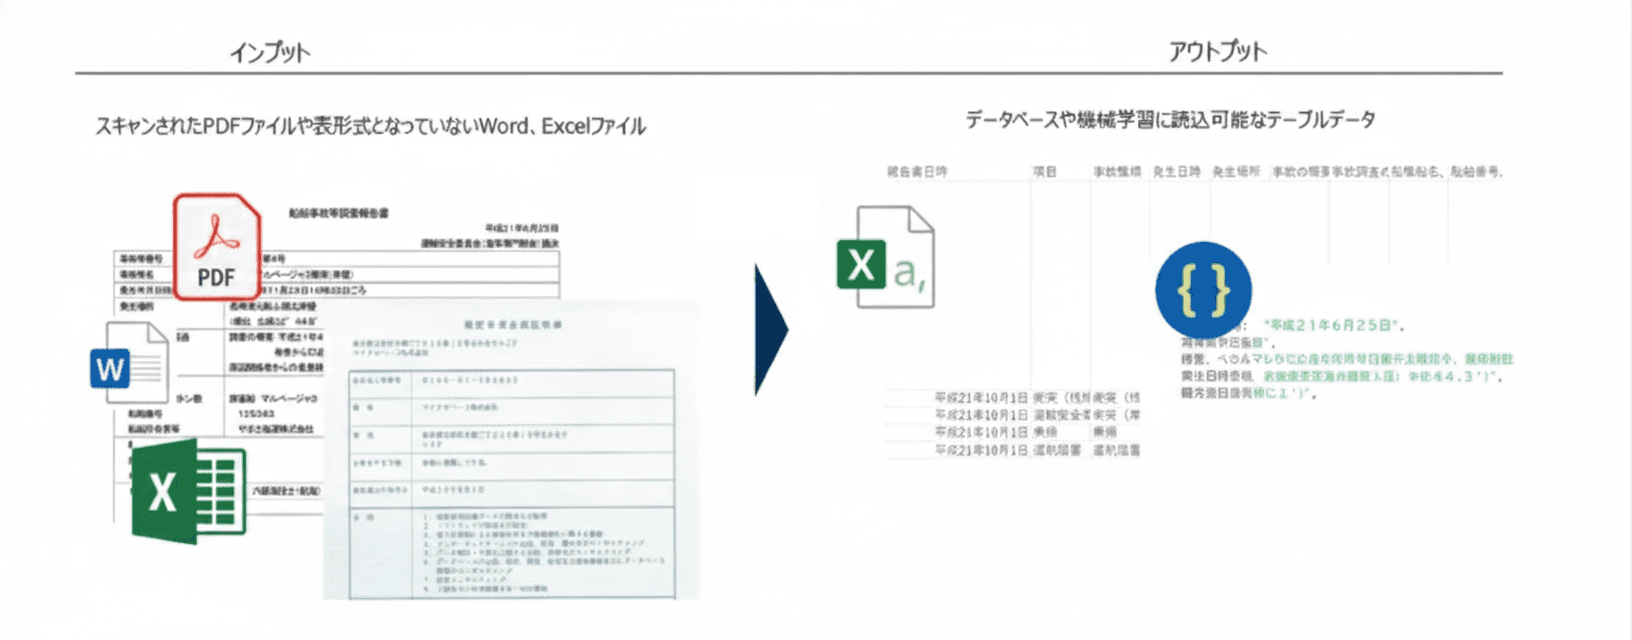
こんにちは、マイクロベースのAI開発チームの「データ構造化」という取り組みについて、オープンデータを題材に紹介します。 「データ構造化」とは、ばらばらに記載された文章やPDF、報告書などの非構造化データを、コンピュータが扱いやすい形(CSVやデータベース)に変換することを指します。AIを活用することで、この作業を効率的かつ高精度に行えるようになってきました。マイクロベースにおいて、証明書や契約書といったドキュメントを機械学習に読込可能なデータセットに変換するサービスに取り組んでおり、これからデータ構造化に取り組まれる方向けに紹介いたします。 船舶事故報告書を題材に 今回取り上げるのは、国土交通省が公開している「船舶事故報告書」。 この報告書には、事故の発生日時や場所、関係する船舶名、原因、再発防止策などが文章形式で記載されています。 https://embed.zenn.studio/card#zenn-embedded__98c2e755d457c こうした報告書をそのまま読むのは人間にとっては容易ですが、統計的に分析したり、GIS(地図システム)に載せたりするには「構造化」されていることが必要です。 そこで、以下のようなポイントを意識してデータ化を行いました。 発生場所:海上事故は住所が存在しないため、報告書に記載された緯度経度を直接抽出 関係船舶:衝突や玉突き事故では複数の船舶が関与するため、最大6船舶まで記録できるスキーマを準備 日付:和暦で書かれているケースも多いため、西暦に変換して保存 自由記述:事故の概要、原因、再発防止策などは要約してテキスト化 生成AIによる構造化 以前はルールベースや正規表現で手作業に近い処理をしていましたが、現在は生成AI(LLM)を使ったアプローチを取り入れています。 例えば、報告書のPDFをAIに読み込ませて以下のように指示します: 「この報告書から、発生日時、発生場所、関係船舶、事故種類、原因、再発防止策を抽出し、JSON形式で出力してください。」 すると、AIが文章を解析して、事前に指定したスキーマに沿った形でデータを返してくれます。 シンプルな報告書なら小型モデル(例:Haiku)でも対応可能で、大規模モデルを使えばより複雑な文章も正確に抽出できます。 出力結果イメージ 構造化の結果は以下のようなCSVにまとまります。 このようにデータ化することで、事故の傾向分析や、地図上での可視化、再発防止策の比較検討などが容易になります。 考察 実際にやってみて感じたのは次の2点です。 1.モデルごとの得意不得意がある短文の抽出は軽量モデルで十分ですが、長文の「事故の概要」や「原因」抽出では大規模モデルが安定。 2.スキーマ設計が肝どの項目を抽出するかをあらかじめ定義しておかないと、AIが返す結果もバラつきが大きくなるため、事前設計が重要です。 まとめ ・データ構造化は、非構造データを機械可読な形式に変換するプロセス ・船舶事故報告書のような公開データを題材にすることで、社会的にも意義のある活用が可能 ・生成AIを使うと、従来より効率的に精度の高いデータ化が実現できる 最後に 私たちは「データ構造化 × 生成AI」をキーワードに、公共データや業務文書を整理・活用する技術を磨いています。 もしこの記事を読んで「こういう取り組みに関わってみたい」と思った方がいれば、ぜひ採用ページ をご覧ください。

Column